
LeetCodeCampsDay51图论part02
包含深度优先搜索和广度优先搜索的基础代码
99. 岛屿数量
https://kamacoder.com/problempage.php?pid=1171
题目描述
给定一个由 1(陆地)和 0(水)组成的矩阵,你需要计算岛屿的数量。岛屿由水平方向或垂直方向上相邻的陆地连接而成,并且四周都是水域。你可以假设矩阵外均被水包围。
输入描述
第一行包含两个整数 N, M,表示矩阵的行数和列数。
后续 N 行,每行包含 M 个数字,数字为 1 或者 0。
输出描述
输出一个整数,表示岛屿的数量。如果不存在岛屿,则输出 0。
输入示例
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1输出示例
3提示信息
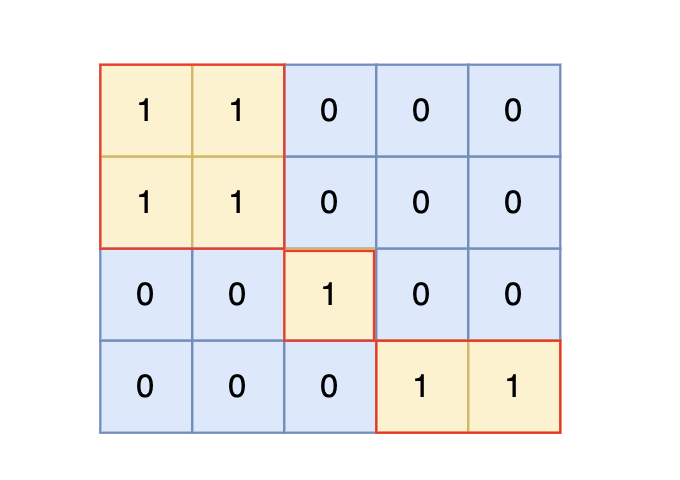
根据测试案例中所展示,岛屿数量共有 3 个,所以输出 3。
数据范围:
1 <= N, M <= 50
图论思路
注意题目中每座岛屿只能由水平方向和/或竖直方向上相邻的陆地连接形成。
也就是说斜角度链接是不算了, 例如示例二,是三个岛屿,如图:

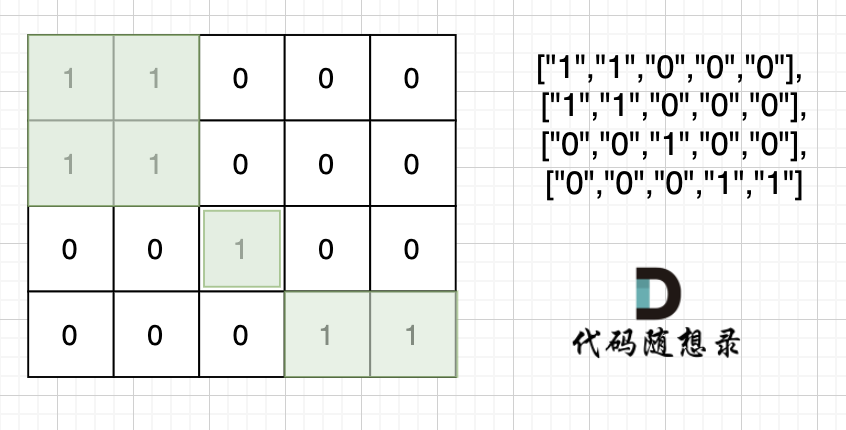
这道题题目是 DFS,BFS,并查集,基础题目。
本题思路,是用遇到一个没有遍历过的节点陆地,计数器就加一,然后把该节点陆地所能遍历到的陆地都标记上。
在遇到标记过的陆地节点和海洋节点的时候直接跳过。 这样计数器就是最终岛屿的数量。
那么如何把节点陆地所能遍历到的陆地都标记上呢,就可以使用 DFS,BFS或者并查集
深度优先DFS代码
direction = [[1,0],[0,1],[-1,0],[0,-1]]

def dfs(graph, visited, x, y) -> int:
  	# 注意,仅探索x,y的上、下、左、右相邻的区域
    for i in range(4):
        nextX = x + direction[i][0]
        nextY = y + direction[i][1]
        if nextX<0 or nextX>=len(graph) or nextY<0 or nextY >= len(graph[0]):
            continue
        if visited[nextX][nextY] == 0 and graph[nextX][nextY] == 1:
            visited[nextX][nextY] = 1
            dfs(graph, visited, nextX, nextY)

def main():
    n, m = map(int, input().split())

    table = []
    res = 0
    for _ in range(n):
        table.append(list(map(int, input().split())))


    visited = [[0] * (m) for _ in range(n)]
    for i in range(n):
        for j in range(m):
            if visited[i][j] == 0 and table[i][j] == 1:
                visited[i][j] == 1
                res += 1
                # 把i,j附近相邻的区域(上、下、左、右相邻位置)全部标记为1(已经探索过)
                dfs(table, visited, i, j)
    print(res)

if __name__ == "__main__":
main()上面的dfs代码没有直接写终止条件,也可以直接写终止条件
direction = [[1,0],[0,1],[-1,0],[0,-1]]

def dfs(graph, visited, x, y) -> int:
  	# 表示 如果当前节点已经被访问或者本身不可达,则直接返回
    if visited[x][y] == 1 or graph[x][y] == 0:
      	return
    # 记录为访问过
    visited[x][y] = 1

  	# 注意,仅探索x,y的上、下、左、右相邻的区域
    for i in range(4):
        nextX = x + direction[i][0]
        nextY = y + direction[i][1]
        if nextX<0 or nextX>=len(graph) or nextY<0 or nextY >= len(graph[0]):
            continue
        dfs(graph, visited, nextX, nextY)

def main():
    n, m = map(int, input().split())

    table = []
    res = 0
    for _ in range(n):
        table.append(list(map(int, input().split())))


    visited = [[0] * (m) for _ in range(n)]
    for i in range(n):
        for j in range(m):
            if visited[i][j] == 0 and table[i][j] == 1:
                # visited[i][j] == 1, 注意这种先判断终止条件的写法不需要在前面将当前位置设置已经去过
                res += 1
                # 把i,j附近相邻的区域(上、下、左、右相邻位置)全部标记为1(已经探索过)
                dfs(table, visited, i, j)
    print(res)

if __name__ == "__main__":
main()在二叉树里,深度优先搜索和前、中、后序遍历可以对应上
而广度优先遍历则可以和层序遍历对应上
广搜的过程
上面我们提过,BFS是一圈一圈的搜索过程,但具体是怎么一圈一圈来搜呢。
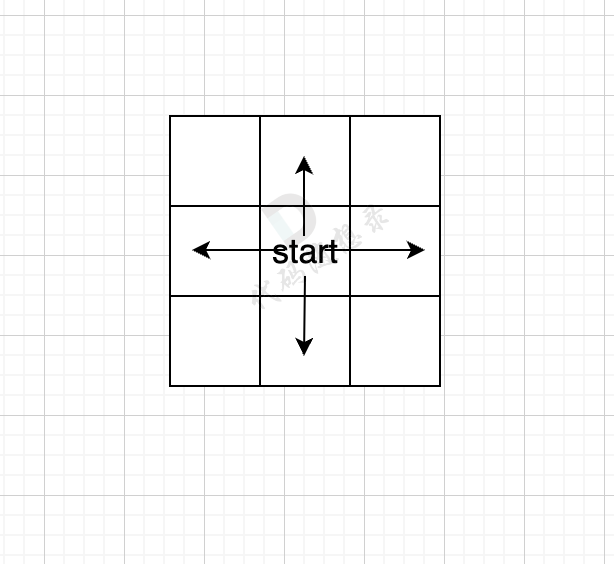
我们用一个方格地图,假如每次搜索的方向为 上下左右(不包含斜上方),那么给出一个start起始位置,那么BFS就是从四个方向走出第一步。
如果加上一个end终止位置,那么使用BFS的搜索过程如图所示:
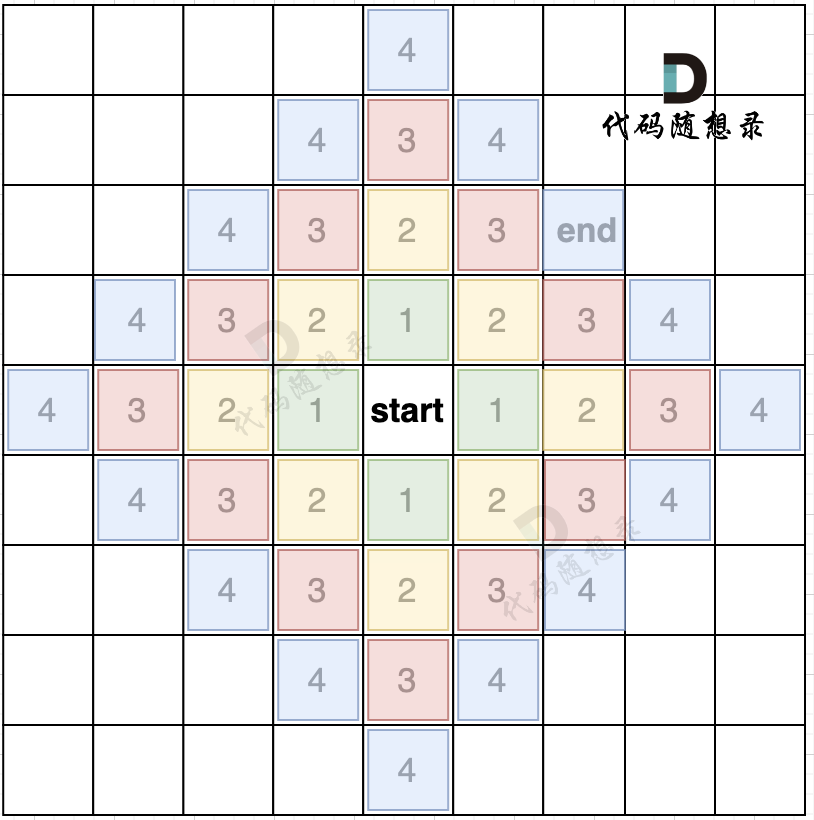
我们从图中可以看出,从start起点开始,是一圈一圈,向外搜索,方格编号1为第一步遍历的节点,方格编号2为第二步遍历的节点,第四步的时候我们找到终止点end。
正是因为BFS一圈一圈的遍历方式,所以一旦遇到终止点,那么一定是一条最短路径。
而且地图还可以有障碍,如图所示:
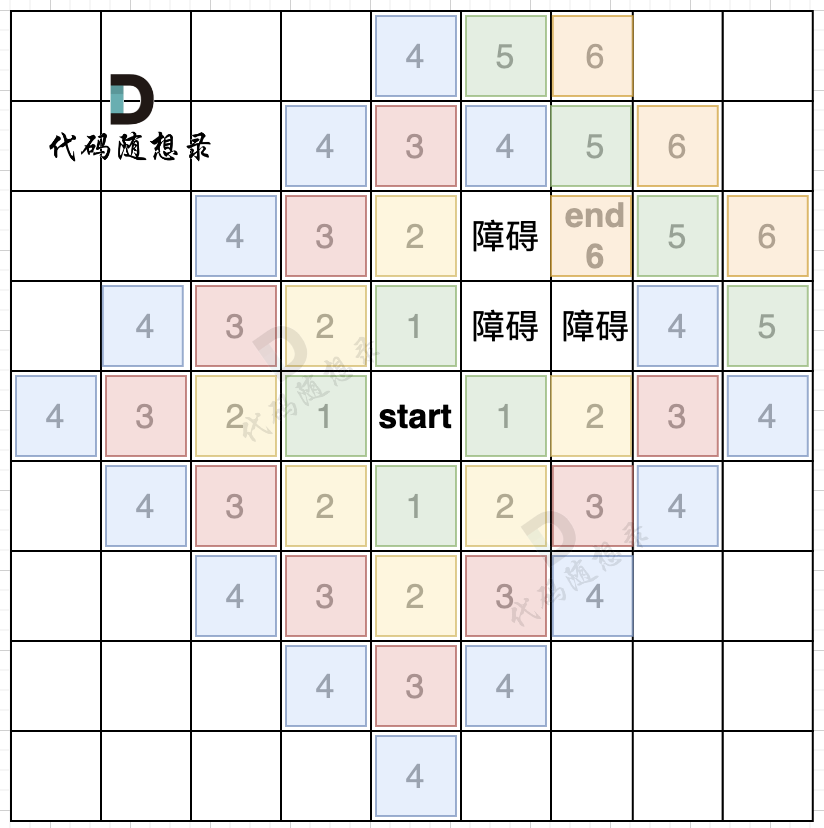
在第五步,第六步 我只把关键的节点染色了,其他方向周边没有去染色,大家只要关注关键地方染色的逻辑就可以。
从图中可以看出,如果添加了障碍,我们是第六步才能走到end终点。
只要BFS只要搜到终点一定是一条最短路径,大家可以参考上面的图,自己再去模拟一下
代码框架
大家应该好奇,这一圈一圈的搜索过程是怎么做到的,是放在什么容器里,才能这样去遍历。
很多网上的资料都是直接说用队列来实现。
其实,我们仅仅需要一个容器,能保存我们要遍历过的元素就可以,那么用队列,还是用栈,甚至用数组,都是可以的。
用队列的话,就是保证每一圈都是一个方向去转,例如统一顺时针或者逆时针。
因为队列是先进先出,加入元素和弹出元素的顺序是没有改变的。
如果用栈的话,就是第一圈顺时针遍历,第二圈逆时针遍历,第三圈有顺时针遍历。
因为栈是先进后出,加入元素和弹出元素的顺序改变了。
那么广搜需要注意 转圈搜索的顺序吗? 不需要!
所以用队列,还是用栈都是可以的,但大家都习惯用队列了,所以下面的讲解用我也用队列来讲,只不过要给大家说清楚,并不是非要用队列,用栈也可以。
广度优先BFS代码
direction = [[1,0],[0,1],[-1,0],[0,-1]]

# 广搜索用队列会方便一些,但使用栈也可以
def bfs(graph, visited, x, y):
    from collections import deque

    que = deque()
    que.append([x, y])
    visited[x][y] = True

    while que:
        curX, curY = que.popleft()
        for i, j in direction:
            nextX = curX + i
            nextY = curY + j
            if nextX<0 or nextX>=len(graph) or nextY<0 or nextY >= len(graph[0]):
                continue
            if visited[nextX][nextY] == 0 and graph[nextX][nextY] == 1:
                visited[nextX][nextY] = 1
                que.append([nextX, nextY])

def main():
    n, m = map(int, input().split())

    table = []
    res = 0
    for _ in range(n):
        table.append(list(map(int, input().split())))


    visited = [[0] * (m) for _ in range(n)]
    for i in range(n):
        for j in range(m):
            if visited[i][j] == 0 and table[i][j] == 1:
                visited[i][j] == 1
                res += 1
                bfs(table, visited, i, j)
    print(res)

if __name__ == "__main__":
main()100. 岛屿的最大面积
题目描述
给定一个由 1(陆地)和 0(水)组成的矩阵,计算岛屿的最大面积。岛屿面积的计算方式为组成岛屿的陆地的总数。岛屿由水平方向或垂直方向上相邻的陆地连接而成,并且四周都是水域。你可以假设矩阵外均被水包围。
输入描述
第一行包含两个整数 N, M,表示矩阵的行数和列数。后续 N 行,每行包含 M 个数字,数字为 1 或者 0,表示岛屿的单元格。
输出描述
输出一个整数,表示岛屿的最大面积。如果不存在岛屿,则输出 0。
输入示例
4 5
1 1 0 0 0
1 1 0 0 0
0 0 1 0 0
0 0 0 1 1输出示例
4提示信息

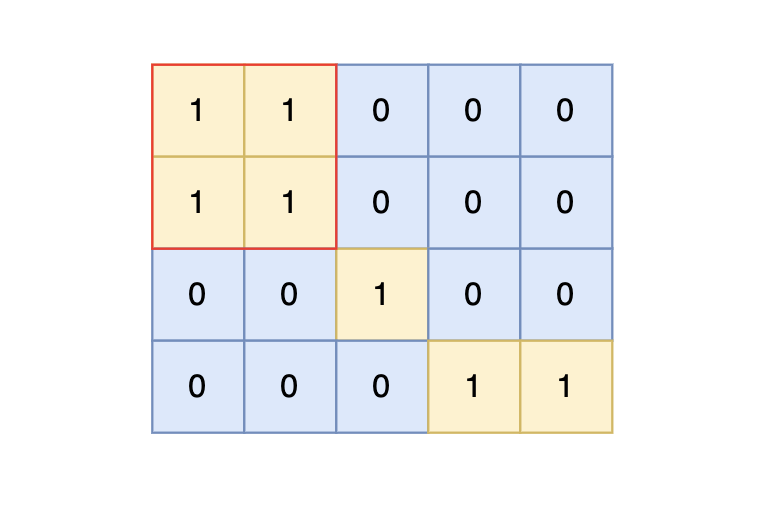
样例输入中,岛屿的最大面积为 4。
数据范围:
1 <= M, N <= 50。
深度优先思路
和上面题目很像,但这次是求每个小岛的面积,也那在对每个小岛开始遍历时,需要在dfs函数里统计相邻块的面积
就是搜索每个岛屿上“1”的数量,然后取一个最大的。
深度优先DFS代码
- 时间复杂度O(m + n)
- 空间复杂度O(m + n)
direction = [[0, 1], [1, 0], [-1, 0], [0, -1]]

def dfs(graph, visited, x: int, y: int) -> int:
    area = 1
    for i, j in direction:
        nextX = x + i
        nextY = y + j
        # 如果下一个节点不可达,直接跳过
        if nextX < 0 or nextY < 0 or nextX >= len(graph) or nextY >= len(graph[0]):
            continue
        if graph[nextX][nextY] == 1 and visited[nextX][nextY]== 0:
            visited[nextX][nextY] = 1
            area += dfs(graph, visited, nextX, nextY)

    return area


def main():
    n, m = map(int, input().split())
    graph = list()
    for i in range(n):
        graph.append(list(map(int, input().split())))

    res = 0
    visited = [[0] * m for _ in range(n)]
    for i in range(n):
        for j in range(m):
            if graph[i][j] == 1 and visited[i][j] == 0:
                visited[i][j] = 1
                # 搜索每个岛屿上“1”的数量,然后取一个最大的。
                res = max(dfs(graph, visited, i, j), res)

    print(res)

if __name__ == "__main__":
main()深度优先代码2
- 时间复杂度O(m + n)
- 空间复杂度O(m + n)
direction = [[0, 1], [1, 0], [-1, 0], [0, -1]]

def dfs2(graph, visited, x: int, y: int) -> int:
  	# 注意要写终止条件,并且返回0
    if graph[x][y] == 0 or visited[x][y] == 1:
        return 0
    # 单层逻辑

    # 当前位置记录为已经去过
    visited[x][y] = 1
    # 初始化面积为1
    area = 1
    for i, j in direction:
        nextX = x + i
        nextY = y + j
        # 如果越界则跳过
        if nextX < 0 or nextY < 0 or nextX >= len(graph) or nextY >= len(graph[0]):
            continue
        # 将面积增加
        area += dfs2(graph, visited, nextX, nextY)

    return area


def main():
    n, m = map(int, input().split())
    graph = list()
    for i in range(n):
        graph.append(list(map(int, input().split())))

    res = 0
    visited = [[0] * m for _ in range(n)]
    for i in range(n):
        for j in range(m):
            if graph[i][j] == 1 and visited[i][j] == 0:
                # visited[i][j] = 1
                # 搜索每个岛屿上“1”的数量,然后取一个最大的。
                res = max(dfs2(graph, visited, i, j), res)

    print(res)

if __name__ == "__main__":
main()广度优先代码
- 时间复杂度O(m + n)
- 空间复杂度O(m + n)
def bfs(graph, visited, x: int, y: int) -> int:
    from collections import deque

    que = deque()
    que.append([x, y])

    area = 1
    while que:
        curX, curY = que.popleft()
        for i, j in direction:
            nextX = curX + i
            nextY = curY + j

            if nextX < 0 or nextY < 0 or nextX >= len(graph) or nextY >= len(graph[0]):
                continue
            if graph[nextX][nextY] == 1 and visited[nextX][nextY] == 0:
                area += 1
                visited[nextX][nextY] = 1
                que.append([nextX,nextY])
    return area


def main():
    n, m = map(int, input().split())
    graph = list()
    for i in range(n):
        graph.append(list(map(int, input().split())))

    res = 0
    visited = [[0] * m for _ in range(n)]
    for i in range(n):
        for j in range(m):
            if graph[i][j] == 1 and visited[i][j] == 0:
                visited[i][j] = 1
                # 搜索每个岛屿上“1”的数量,然后取一个最大的。
                res = max(bfs(graph, visited, i, j), res)

    print(res)

if __name__ == "__main__":
main()- 文章作者:
- Lthero博客
- 版权声明:
- 本博客所有文章除特别声明外,均采用CC BY-NC-SA 4.0许可协议。转载请注明来自 Lthero博客!


