
【Diffusion】基于分数的生成模型
基于分数的生成模型
(Score-based generative models)
原文链接:
通过前面的学习,我们发现扩散模型可以从不同的角度进行解释。 其中一个等价的解释是基于分数的生成模型,前面章节虽然简单介绍了下, 但没有详细说明,本章我们详细讨论下基于分数的生成模型。 基于分数的生成模型是由宋旸等人在2019年提出 [1] 的, 后来他们又提出了基于随机微分方程的更一般的形式 [2], 本章我们一起讨论学习一下。
Scored-based的生成模型
在前面 DDPM 和 DDIM 的章节中,已经探讨了 DDPM 的降噪过程,可以看做是沿着分数(梯度)∇logp(xt)∇logp(x_t)∇logp(xt)前进。然而宋旸等人提出基于分数(Score-based)的论文 相关工作并不是建立在 DDPM 的基础上,所以论文里不是从DDPM的马尔科夫链式结构讨论和导出的,而是直接从分数匹配估计算法推导。
首先看下基于分数的生成模型的核心思想。假设我们有一些服从某个分布的观察数据,比如大量的图片数据, 但是这些数据背后真实的概率分布是未知的, 我们暂且用符号 pdata(x)p_{data}(x)pdata(x)表示这些观测数据的真实分布。
我们希望能生成新的数据,也就是想从分布pdata(x)p_{data}(x)pdata(x)中采样新的样本,比如采样生成新的图片。
但分布pdata(x)p_{data}(x)pdata(x)是未知的,怎么办呢? 此时有一种利用分数(score)进行采样的方法,虽然我们不知道pdata(x)p_{data}(x)pdata(x)的具体形式, 但如果我们能得到它的分数$$∇_xlog(p_{data}(x))$$(基于数据变量xxx的一阶偏导), 那么就可以利用它的分数$$∇_xlog(p_{data}(x))$$从pdata(x)p_{data}(x)pdata(x)中随机采样。
为什么对log(pdata(x))log(p_data(x))log(pdata(x))进行求导?
- 使用对数概率 log(p(x)) 而非直接使用 p(x) 有几个原因。首先,对数转换可以帮助稳定数值计算,因为概率值 p(x) 可能非常小,直接处理这些小数可能导致数值不稳定。其次,对数转换增加了梯度的灵敏度,对于低概率区域,即使是微小的概率变化,也会在对数尺度上产生较大的变化,从而使模型能够更敏感地捕捉到数据分布的细微特征。
- 自然梯度与分数匹配:在统计学习和信息理论中,自然梯度(即概率分布的梯度)被用于描述信息几何中的最优化问题。分数匹配算法就是利用了这一点,通过匹配数据分布的梯度来学习和近似真实分布。这种方法直接对接到了概率分布的本质特征上,使得模型能够更加精确地捕捉和生成数据。
- 简化学习问题:当我们使用 log(p(x)) 的梯度时,学习问题简化为学习这个梯度的近似表示。这通常比直接学习复杂的数据分布 p(x) 更容易,因为梯度信息提供了关于如何调整参数以更好地逼近数据分布的直接指导。
这样基于分数的采样方法有很多,可以从中选择一个合适的采样方法。 所以基于分数的生成模型,宏观来看就两步:
- 利用分数匹配方法估计出数据分布 pdata(x)p_{data}(x)pdata(x) 的近似分数 sθ(x)≈∇xlogpdata(x)s_{\theta}(x) \approx \nabla_{x} \log p_{\text{data}}(x)sθ(x)≈∇xlogpdata(x) 。
- 使用这个基于近似分数 sθ(x)s_{\theta}(x)sθ(x) 的采样算法,随机采样近似数据分布 pdata(x)p_{\text{data}}(x)pdata(x) 的样本。
分数匹配算法(Score Matching)
分数匹配(Score Matching),简单来说它就是一种概率密度估计的方法。 该方法在多元高斯和独立分量分析模型上得到了证明 3。 在概率统计学中,很多概率密度函数可以写成如下的形式,比如无向图中的概率密度,通过贝叶斯公式推导出的后验概率分布等等。
公式1.1
p(x;θ)=q(x;θ)Zp(x;\theta) = \frac{q(x;\theta)}{Z} p(x;θ)=Zq(x;θ)
其中
- θ\thetaθ 是未知参数
- xxx 是我们感兴趣的目标随机变量,可以是一个多元向量。
- ZZZ 作为分母,它起到归一化的作用,使得式子 q(x;θ)/Zq(x;\theta)/Zq(x;θ)/Z 的积分为 111,进而满足概率密度的约束。多数情况下,尤其是使用了贝叶斯定理的情况,ZZZ 本身就是分子的积分
公式1.2
Z=∫q(x;θ)dxZ = \int q(x;\theta) dx Z=∫q(x;θ)dx
然而很多情况下ZZZ是难以计算的,甚至无法计算的,这就导致我们无法得到概率密度 p(x;θ)p(x;\theta)p(x;θ) 的准确形式,虽然用最大似然估计能帮我们估计出未知参数 θ\thetaθ,但没办法得到 p(x;θ)p(x;\theta)p(x;θ) 的完整形式,也就不能从 p(x;θ)p(x;\theta)p(x;θ) 进行样本生成等等工作。
而分数匹配就是帮我们估计出 p(x;θ)p(x;\theta)p(x;θ) 的一个近似表示,我们用这个近似表示来代替原本的 p(x;θ)p(x;\theta)p(x;θ)。
假设我们有变量 xxx 的一些观测样本,我们用 pdata(x)p_{\text{data}}(x)pdata(x) 表示这些数据的真实分布,然后定义一个近似的参数化分布(训练的模型)表示为 pθ(x)p_{\theta}(x)pθ(x),分数匹配的目标函数是
公式1.3
J(θ)=12∫pdata(x)∥∇logpdata(x)−∇logpθ(x)∥2dx=12E[pdata(x)]∥∇logpdata(x)−∇logpθ(x)∥2J(\theta) \\= \frac{1}{2} \int p_{\text{data}}(x) \left\lVert \nabla \log p_{\text{data}}(x) - \nabla \log p_{\theta}(x) \right\rVert^2 d x \\=\frac{1}{2} \mathbb{E}[p_{\text{data}}(x)]{ \left\lVert \nabla \log p_{\text{data}}(x) - \nabla \log p_{\theta}(x) \right\rVert^2 } J(θ)=21∫pdata(x)∥∇logpdata(x)−∇logpθ(x)∥2dx=21E[pdata(x)]∥∇logpdata(x)−∇logpθ(x)∥2
为了符号简洁,分别定义 sθ(x)=∇logpθ(x)s_{\theta}(x)=\nabla \log p_{\theta}(x)sθ(x)=∇logpθ(x),sdata(x)=∇logpdata(x)s_{data}(x)=\nabla \log p_{\text{data}}(x)sdata(x)=∇logpdata(x),注意这里的梯度都是对变量 xxx 的,不是对参数 θ\thetaθ,别搞混了。
公式1.4
J(θ)=12∫pdata(x)∥sdata(x)−sθ(x)∥22dx=12E[pdata(x)]∥sdata(x)−sθ(x)∥22J(\theta) \\= \frac{1}{2} \int p_{\text{data}}(x) \left\lVert s_{data}(x) - s_{\theta}(x) \right\rVert^2_2 d x \\= \frac{1}{2} \mathbb{E}[p_{\text{data}}(x)]{ \left\lVert s_{data}(x) - s_{\theta}(x) \right\rVert^2_2 } J(θ)=21∫pdata(x)∥sdata(x)−sθ(x)∥22dx=21E[pdata(x)]∥sdata(x)−sθ(x)∥22
通过极小化目标函数求得参数化分布的未知参数θ\thetaθ
θ^=argminθ J(θ) \hat{\theta} = \operatorname*{\arg \min}_{\theta} \ J(\theta) θ^=θargmin J(θ)
单纯的看这个目标函数似乎很简单,他就是一个均方误差而已,它的目标是令近似分布的对数概率密度梯度和真实数据分布的对数概率密度的梯度尽量相近,这其实建立在:如果两个分布的对数密度梯度是一样的,那么他们的概率密度也是一样的。这个目标函数形式很简单,但是有个问题,就是 sdata(x)s_{data}(x)sdata(x) 是不知道的,是无法计算的。
得到了目标函数的一个等价表示
公式1.5
J(θ)=∫pdata(x)[tr(∇xsθ(x))+12∥sθ(x)∥22]dx=E[pdata(x)]tr(∇xsθ(x))+12∥sθ(x)∥22J(\theta) \\= \int p_{\text{data}}(x) \left [ tr( \nabla_{x} s_{\theta}(x)) + \frac{1}{2} \left\lVert s_{\theta}(x) \right\rVert^2_2 \right ] d x \\= \mathbb{E}[p_{\text{data}}(x)] { tr( \nabla_{x} s_{\theta}(x)) + \frac{1}{2} \left\lVert s_{\theta}(x) \right\rVert^2_2 } J(θ)=∫pdata(x)[tr(∇xsθ(x))+21∥sθ(x)∥22]dx=E[pdata(x)]tr(∇xsθ(x))+21∥sθ(x)∥22
其中 ∇xsθ(x)\nabla_{x} s_{\theta}(x)∇xsθ(x) 是 sθ(x)s_{\theta}(x)sθ(x) 的一阶偏导,是 logpθ(x)\log p_{\theta}(x)logpθ(x) 的二阶偏导,因为是二阶偏导,所以他是一个方阵,也被称为 Hessian 矩阵, tr(⋅)tr(\cdot)tr(⋅) 表示对角线元素。sθ(x)s_{\theta}(x)sθ(x) 是我们的近似分布(拟合模型)的一阶偏导,它是可以计算的。在这个等价表示中,没有了数据分布的梯度,只剩下了可以计算的拟合模型的梯度。
从公式1.4 到公式1.5 的推导过程这里不再赘述,详细过程可以参考论文 EstimationofNon-NormalizedStatisticalModels byScoreMatching 。
然而事情还没有完,二阶偏导 tr(∇xsθ(x))tr( \nabla_{x} s_{\theta}(x))tr(∇xsθ(x)) 虽然可以计算,但是计算成本时非常高的,尤其是在变量 xxx 很高维或者神经网络层次很深的时候,通常是无法接受的。针对这个情况,一般有两种解决方法,分层分数匹配(Sliced score matching)和降噪分数匹配(Denoising score matching)。
分层分数匹配(Sliced score matching)
分层分数匹配使用一个随机投影矩阵可以 近似 计算 tr(∇xsθ(x))tr( \nabla_{x} s_{\theta}(x))tr(∇xsθ(x)),改变后的目标函数为
公式1.6
EpvE[pdata(x)]vT∇xsθ(x)v+12∥sθ(x)∥22 \mathbb{E}_{p_v} \mathbb{E}[p_{\text{data}}(x)] { v^T \nabla_{x} s_{\theta}(x) v + \frac{1}{2} \left\lVert s_{\theta}(x) \right\rVert^2_2 } EpvE[pdata(x)]vT∇xsθ(x)v+21∥sθ(x)∥22
其中 pvp_vpv 是一个简单的随机向量即可,比如多元正态分布。其中 vT∇xsθ(x)vv^T \nabla_{x} s_{\theta}(x) vvT∇xsθ(x)v 可以直接利用正向模式的自动微分计算,但是仍然要四倍的计算量。
降噪分数匹配(Denoising score matching)
另一种解决分数匹配的方法是降噪分数匹配(Denoising score matching),它是分数匹配算法的一个变种,它可以完全避开 tr(∇xsθ(x))tr( \nabla_{x} s_{\theta}(x))tr(∇xsθ(x)) 的计算。首先在观测数据 xxx 上添加一些预先设定好的噪声数据,得到了新的数据 x~\tilde{x}x~,这相当于构建了一条件概率分布 qσ(x~∣x)q_{\sigma}(\tilde{x}|x)qσ(x~∣x),根据边际化方法,边缘分布qσ(x~)q_{\sigma}(\tilde{x})qσ(x~) 的计算方法为
公式1.7
qσ(x~)≜∫qσ(x~∣x)pdata(x)dx q_{\sigma}(\tilde{x}) \triangleq \int q_{\sigma}(\tilde{x}|x) p_{\text{data}}(x) d x qσ(x~)≜∫qσ(x~∣x)pdata(x)dx
然后把分数匹配算法应用在这个加噪后的数据分布上,
公式1.8
12Eqσ(x~∣x)[∥sθ(x~)−∇x~logqσ(x~)∥22]=12Eqσ(x~∣x)pdata(x)[∥sθ(x~)−∇x~logqσ(x~∣x)∥22]\frac{1}{2} \mathbb{E}_{q_{\sigma}(\tilde{x}|x) } \left [ \left\lVert s_{\theta}(\tilde{x}) -\nabla_{\tilde{x}} \log q_{\sigma}(\tilde{x}) \right\rVert^2_2 \right ] \\= \frac{1}{2} \mathbb{E}_{q_{\sigma}(\tilde{x}|x) p_{\text{data}}(x) } \left [ \left\lVert s_{\theta}(\tilde{x}) -\nabla_{\tilde{x}} \log q_{\sigma}(\tilde{x}|x) \right\rVert^2_2 \right ] 21Eqσ(x~∣x)[∥sθ(x~)−∇x~logqσ(x~)∥22]=21Eqσ(x~∣x)pdata(x)[∥sθ(x~)−∇x~logqσ(x~∣x)∥22]
这么做的一个前提是,如果添加的噪声足够小,那么 qσ(x~)≈pdata(x)q_{\sigma}(\tilde{x}) \approx p_{\text{data}}(x)qσ(x~)≈pdata(x)成立,此时有 ∇x~logqσ(x~)≈∇xlogpdata(x)\nabla_{\tilde{x}} \log q_{\sigma}(\tilde{x}) \approx \nabla_{x} \log p_{\text{data}}(x)∇x~logqσ(x~)≈∇xlogpdata(x)成立,这时我们可以用分数匹配算法估计出 qσ(x~)q_{\sigma}(\tilde{x})qσ(x~) 的分数 ∇x~logqσ(x~)\nabla_{\tilde{x}} \log q_{\sigma}(\tilde{x})∇x~logqσ(x~),并用它近似表示原数据分布 pdata(x)p_{\text{data}}(x)pdata(x) 的分数。
从中,我们知道了Diffusion核心思想
- 原样本xxx的概率分布pdata(x)p_{data}(x)pdata(x)我们不知道,但我们要知道它(从而生成新样本)
- 于是,给样本xxx添加预定的噪声(噪声很小),从而得到一堆新样本x~\tilde xx~ ,从而知道x~\tilde xx~ 的概率分布 qσ(x~∣x)q_{\sigma}(\tilde{x}|x)qσ(x~∣x) ,通过边缘化计算方法(对xxx积分)从而求出qσ(x~)q_{\sigma}(\tilde{x})qσ(x~)
- 如果噪声很小,我们可以认为 qσ(x~)≈pdata(x)q_{\sigma}(\tilde{x}) \approx p_{\text{data}}(x)qσ(x~)≈pdata(x) ,这样的话,就可以近似得到了原样本xxx的概率分布
网络逐渐学会如何从给定的噪声分布中生成样本,同时也学会了如何去除这些噪声以还原出原始样本。这意味着网络在逐渐学习并逼近了pdata(x)p_{data}(x)pdata(x)的概率分布qσ(x~)q_{\sigma}(\tilde{x})qσ(x~)

基于分数的生成模型面临的困难
理想是美好的,现实是残酷的。虽然我们想到了这种基于分数的采样模型,然而在实际应用时需要面临一些困难,论文中主要提出了两类困难:
- 分数匹配算法估计分数的准确性问题。
- 基于分数的采样算法的准确性问题。
分数估计不准的问题
论文中一共提出两个原因会导致分数估计不准确,一个是流体假设问题,一个是低密度区域样本不足的问题。
流形假设问题
首先看流体假设问题,论文指出了流形假设的存在,即现实世界中的数据往往集中在嵌入高维空间的低维流形上。
这句话对数学不好的同学来说跟天书一样,说人话就是,你观测的数据 xxx 是 nnn 维,你以为它真的就是 nnn 维吗?现实是:多数情况下,数据中含有信息的真正维度往往小于 nnn 维。
比如一张 4096×21604096 \times 21604096×2160 的 4K 高清图像,它的像素点总数是 4096×2160=88473604096 \times 2160=88473604096×2160=8847360,你以为这 880w880w880w 个像素点都是独立有意义的么?未必,我把它压缩到 1920×1080=1080P1920 \times 1080=1080P1920×1080=1080P后,图像的关键信息可能并没有丢失。也就是说原来 4K 图像中很多像素点其实可有可无,并没有包含有意义的信息。
这里我换个容易理解的说法,从小学数学说起。在学线性方程组时,我们知道方程组的解有无解、唯一解、无穷解等等情况。假设有一个包含 nnn个方程和 mmm个未知参数的方程组,有 mmm个参数就有 mmm对应的系数。
但是你的方程与方程之间,系数与系数之间可能存在着线性相关,即某个方程可以通过其它方程线性变化得到,某个系数可以通过其它系数线性变换得到,这样的方程称为无效方程,这样的系数对应的参数称为无效参数或者自由参数。
假设方程组中有意义的方程为 n~\tilde{n}n~ 个,即方程组中独立无关的方程有 n~\tilde{n}n~ 个;相互独立无关的系数有 m~\tilde{m}m~ 个。
有两种情况会导致方程组有无穷解,无穷解意为着不能确定未知参数的值。
- 当 $ \tilde{n}<\tilde{m}$ 时,意为着有意义方程数量不足以确定全部参数的值,此时就方程组会有无穷解。
这种情况,就相当于在机器学习场景中,有意义的观测样本(方程)数量少于观测变量(系数)的数量。 - 当 $ \tilde{n}<n$ 时,此时意为着有部分系数之间不是相互独立的,这些系数对应的参数就成了自由参数,它的值可以是任意的,此时就方程组也会有无穷解。这种情况,就相当于在机器学习场景中,你的特征变量(观测变量)不是相互独立的,存在线性相关。
进入到线性代数,线性方程组可以用形如 Aθ=bA\theta=bAθ=b 的矩阵表达,其中 AAA 是系数矩阵,对应着观测变量的观测值矩阵,或者说特征矩阵,θ\thetaθ 是未知参数组成的向量,bbb 是方程组等号右侧值组成的向量,对应着机器学习场景下的 Label 值向量。
矩阵 AAA 行的数量对应着观测样本的数量,列数对应着观测变量的维数(或者是个数),列数和 θ\thetaθ 向量长度(未知参数数量)是一样的。
如果矩阵 $A $ 列满秩,意味着观测变量(系数)之间是相互独立的,每一个观测变量都含有有意义的信息;反之,如果观测变量(系数)之间是部分存在线性关系(或者一一映射),则矩阵 AAA 列不满秩,矩阵 AAA 的列秩就等于有意义观测变量的数量。
回到流形假设问题,流行假设描述的是 类似列不满秩的情况 ,就是说我们观测到的数据维度是 mmm,但很可能这 mmm个变量(或者说维度)并不是都有意义,其中某些变量(维度)可能没有意义,可以由其它变量组合变换的到,这样的变量本身是不包含任何有价值信息的。
反映到分数估计算法上,这些变量的分数(偏导数)理论上有任意解,不稳定,呈现出来的现象就是训练时 Loss 不稳定不收敛,会反复横跳,具体可以看原论文里的实验和图解。
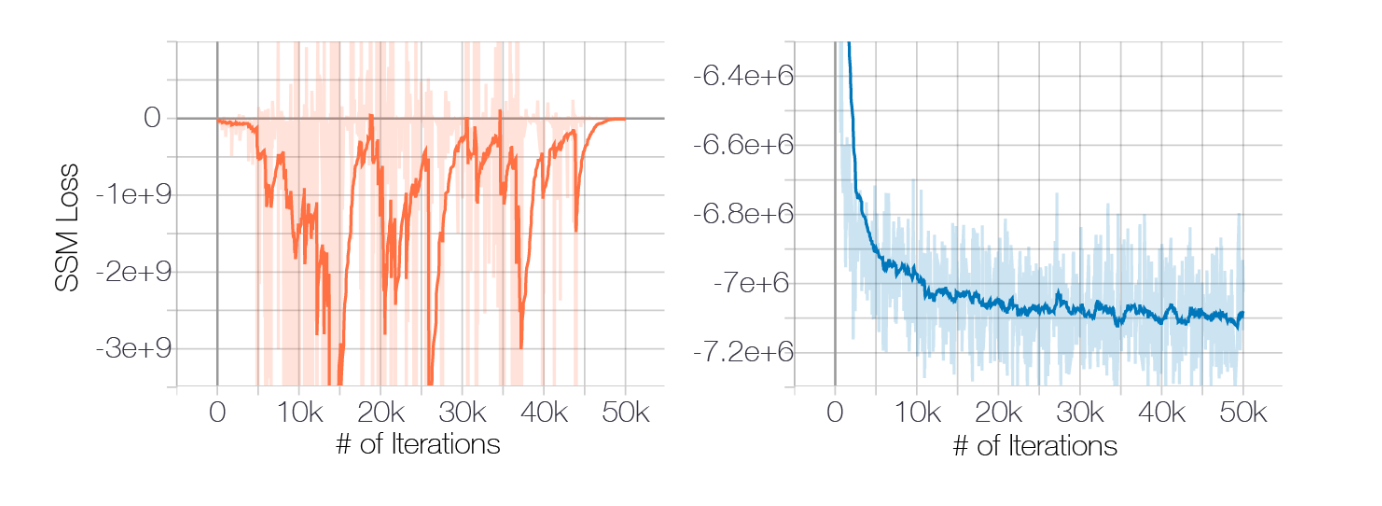
低密度的问题
另一个影响分数估计准确性的是概率密度的低密度问题,这个问题其实很简单, 本质上就是观测样本不足的问题。 我们知道,对于一个非均匀分布的概率分布来说,其概率密度是不均匀的,概率密度低的地方意为着产生概率低, 那理论上获得这些区域的观测样本的概率就小。也就说,大多数情况下,对于低概率密度的区域, 我们观测样本覆盖是不足的,这时自然分数估计算法这些区域的拟合和学习就不足, 显然它对这些区域的预测也将不准。
郎之万动力采样不准的问题
郎之万动力采样(Langevin dynamics sample)算法,是一种利用分数从目标概率分布采样的方法,假设目标概率分布是 p(x)p(x)p(x),它的分数表示为 ∇xlogp(x)\nabla_{x} \log p(x)∇xlogp(x),给定一个固定的步进 ϵ>0\epsilon >0ϵ>0,以及一个初始样本 x~∼π(x)\tilde{x} \sim \pi(x)x~∼π(x),π(x)\pi(x)π(x) 可以认为是一个先验分布,
郎之万动力采样通过如下迭代方程得到一个目标分布 p(x)p(x)p(x) 的采样。
公式1.9
x~t=x~t−1+ϵ2∇xlogp(x~t−1)+ϵzt,zt∼N(0,I)\tilde{x}_{t} = \tilde{x}_{t-1} + \frac{\epsilon}{2} \nabla_{x} \log p( \tilde{x}_{t-1}) + \sqrt{\epsilon} z_t , \quad z_t \sim N(\mathcal{0,\textit{I}}) x~t=x~t−1+2ϵ∇xlogp(x~t−1)+ϵzt,zt∼N(0,I)
当满足 ϵ→0\epsilon \rightarrow 0ϵ→0 ,T→∞T \rightarrow \inftyT→∞ 和一些正则性条件时,x~T\tilde{x}_{T}x~T 就服从分布 p(x)p(x)p(x),此时 x~T\tilde{x}_{T}x~T 可以看成目标分布 p(x)p(x)p(x) 的一个采样
当然如果 ϵ>0\epsilon > 0ϵ>0 并且 T<∞T < \inftyT<∞。采样就不是很准,但实际应用中可以忽略这些误差,勉强能用,我们要做的就是让 ϵ\epsilonϵ 尽量小,让 TTT 尽量大。
郎之万动力采样的优势就是它只需要有目标分布的分数就行了,不需要知道目标分布 p(x)p(x)p(x) 具体形式。
仔细观察下这个公式,这不就是一个梯度迭代法么,让 xtx_txt 逐步沿着 p(x)p(x)p(x) 的梯度向着 p(x)p(x)p(x) 概率密度最大的点前进,迭代过程中加入一个随机高斯噪声 ztz_tzt,使其具备随机性。万变不离其宗,搞来搞去就这么点事!!!
既然就是个梯度迭代,那我加入二阶梯度是不是采样能更快点?
然而郎之万动力采样存在一个显著的缺陷,当数据分布是一个很复杂的分布时,比如存在低密度区域,并且低密度区域把整个概率密度空间分割成多个区域时,郎之万动力采样法无法在合理的时间能得到正确的采样,最典型的例子就是高斯混合分布,原论文就是用两个分量的混合高斯分布做实验和举例,论证了在这种情况下郎之万动力采样法无法健康工作。
当然如果TTT足够大还是可以合理采样的,但实际应用中,没办法令TTT足够大,那样的话迭代次数太多,效率太慢了。
通过加噪的方法估计分布的近似分数
通过上一节,我们知道了基于分数的生成模型,面临两个困难,
- 高维空间有效性问题,有意义信息的维度可能远远小于观测数据的维度,导致分数估计算法不收敛。
- 数据分布低密度区域问题,低密度区域一方面因为样本不足令分数匹配算法估计不准,另一方面使郎之万采样算法无法在可接受的步数内得到有效采样。
那怎么解决呢?你猜对了,通过对数据添加高斯噪声解决。
为什么添加噪声能解决上述问题呢?思考下,原数据分数是 pdata(x)p_{data}(x)pdata(x),再它基础上添加一些高斯噪声,这个过程对应条件概率分布 qσ(x~∣x)q_\sigma(\tilde{x}|x)qσ(x~∣x),添加噪声后得到新的数据 x~\tilde{x}x~ 的边缘分布是 qσ(x~)=∫qσ(x~∣x)pdata(x)dxq_\sigma(\tilde{x}) = \int q_\sigma(\tilde{x}|x) p_{data}(x) dxqσ(x~)=∫qσ(x~∣x)pdata(x)dx,
添加噪声就相当于改变了原来的数据分布,这种改变影响两个方面:
- 会破坏掉原来数据变量 xxx 各个维度(分量)之间的相关性,使得各个维度(分量)间相关性减弱,相当于 xxx 变得满秩了。
- 会改变 pdata(x)p_{data}(x)pdata(x) 的密度,各分量之间添加的噪声是同等权重的,低密度区域会密度变高,相对来说整个密度空间变得均匀了。
添加的噪声越多,对上述两点的影响越大,对问题的改善就越好。这种加噪声的方法又完美契合了上面介绍的分数匹配两种方法之一的降噪分数匹配,就是这么的巧合。
但是,但是,这里有冲突!!!
- 回看一下降噪分数匹配算法,它成立的条件是添加的噪声不能太多啊,不然 qσ(x~)q_\sigma(\tilde{x})qσ(x~) 就离 pdata(x)p_{data}(x)pdata(x) 太远了,就不能用 qσ(x~)q_\sigma(\tilde{x})qσ(x~) 的分数近似 pdata(x)p_{data}(x)pdata(x) 的分数了。
- 但又需要足够的大噪声去改善上述两个问题,噪声不够大,这两个问题解决不彻底啊!!!
那么怎么解决?既然有的人贪心要的多,有的人佛系要的少,重口难调。
那么就按需分配,设置不同强度等级噪声,各种强度等级的噪声都安排上
令 {σi}i=1L\{\sigma_i\}_{i=1}^L{σi}i=1L 是一个满足 σ1σ2=⋯=σL−1σL\frac{\sigma_1}{\sigma_2}=\cdots=\frac{\sigma_{L-1}}{\sigma_{L}}σ2σ1=⋯=σLσL−1的正几何序列。
令条件分布 qσi(x~∣x)q_{\sigma_i}(\tilde{x}|x)qσi(x~∣x) 是一个高斯条件分布,它表示加噪过程,则有
公式1.10
qσi(x~∣x)∼N(x~∣x,σi2I) q_{\sigma_i}(\tilde{x}|x) \sim \mathcal{N}( \tilde{x}|x, \sigma_i^2 \textit{I} ) qσi(x~∣x)∼N(x~∣x,σi2I)
令qσi(x~)q_{\sigma_i}(\tilde{x})qσi(x~)表示加噪扰动后的数据边缘分布,则有
公式1.11
qσi(x~)≜∫pdata(x)qσi(x~∣x)dtq_{\sigma_i}(\tilde{x}) \triangleq \int p_{data}(x) q_{\sigma_i}(\tilde{x}|x) dt qσi(x~)≜∫pdata(x)qσi(x~∣x)dt
和之前一样,可以通过采样法得到x~\tilde{x}x~的样本
公式1.12
x~=x+σi2ϵ,ϵ∼0,I\tilde{x} = x + \sigma^2_i \epsilon , \quad \epsilon \sim \mathcal{0,\textit{I}} x~=x+σi2ϵ,ϵ∼0,I
相比于 DDPM ,这里没有定义一个 α\alphaα 参数,事实上 σi2\sigma^2_iσi2起到了类似的作用。
- σi2\sigma^2_iσi2 从大到小变化
- σ02\sigma^2_0σ02 足够大用来解决上面的问题,
- σL2\sigma^2_LσL2 足够小用来提高分数匹配估计的效果。
直观地,高噪声有助于分数函数的估计,但也会导致样本损坏;而较低的噪声给出了干净的样本,但使得分函数更难估计。
接下来利用上述的分层分数匹配(Sliced score matching)或者降噪分数匹配(Denoising score matching)
学习一个分数估计模型,它能在不同噪声强度下估计出扰动加噪后数据的分数。在这里分层分数匹配和降噪分数匹配两种方法都可以使用,没有特别的限制。
条件高斯分布qσi(x~∣x)q_{\sigma_i}(\tilde{x}| x)qσi(x~∣x) 的分数为
公式1.13
∇x~logqσi(x~∣x)=−x~−xσi2\nabla_{\tilde{x}} \log q_{\sigma_i}(\tilde{x}| x)= - \frac{\tilde{x}-x}{\sigma_i^2} ∇x~logqσi(x~∣x)=−σi2x~−x
按照降噪分数匹配的方法,单一噪声强度的目标函数为
公式1.14
ℓ(θ;σi)≜12Epdata(x)Ex~∼x,σi2I[∥sθ(x~,σi)−∇x~logqσ(x~∣x)∥22]=12Epdata(x)Ex~∼x,σi2I[∥sθ(x~,σi)+x~−xσi2∥22]\ell(\theta;\sigma_i) \\ \triangleq \frac{1}{2} \mathbb{E}_{p_{data}(x)} \mathbb{E}_{\tilde{x} \sim \mathcal{x,\sigma_i^2 \textit{I}}} \left [ \left\lVert s_{\theta}(\tilde{x},\sigma_i) -\nabla_{\tilde{x}} \log q_{\sigma}(\tilde{x}|x) \right\rVert^2_2 \right ] \\ = \frac{1}{2} \mathbb{E}_{p_{data}(x)} \mathbb{E}_{\tilde{x} \sim \mathcal{x,\sigma_i^2 \textit{I}}} \left [ \left\lVert s_{\theta}(\tilde{x},\sigma_i) + \frac{\tilde{x}-x}{\sigma_i^2} \right\rVert^2_2 \right ] ℓ(θ;σi)≜21Epdata(x)Ex~∼x,σi2I[∥sθ(x~,σi)−∇x~logqσ(x~∣x)∥22]=21Epdata(x)Ex~∼x,σi2I[∥∥∥∥∥sθ(x~,σi)+σi2x~−x∥∥∥∥∥22]
sθ(x~,σi)s_{\theta}(\tilde{x},\sigma_i)sθ(x~,σi) 代表神经网络模型,它的输入是 x~\tilde{x}x~ 和 σi\sigma_iσi,输出是预测的分数。最后把所有噪声等级结合在一起
公式1.15
L(θ;{σi}i=1L)≜1L∑i=1Lλ(σi)ℓ(θ;σi)\mathcal{L}(\theta;\{\sigma_i\}_{i=1}^L ) \triangleq \frac{1}{L} \sum_{i=1}^L \lambda(\sigma_i) \ell(\theta;\sigma_i) L(θ;{σi}i=1L)≜L1i=1∑Lλ(σi)ℓ(θ;σi)
这就是最终的目标函数了,其中 λ(σi)\lambda(\sigma_i)λ(σi) 是一个与 σi\sigma_iσi 有关的权重参数,它的作用是可以对不同噪声等级 σi\sigma_iσi 设置不同的重要性权重。
目标函数中包含一个方差项 σi2\sigma_i^2σi2,它是平方,当 σi\sigma_iσi 取不同值时波动比较大,可以认为当 σi\sigma_iσi 取不同值时公式1.14的数量级不同,所以这里可以令 λ(σi)=σi2\lambda(\sigma_i)=\sigma_i^2λ(σi)=σi2
公式1.16
λ(σi)ℓ(θ;σi)=σi212Epdata(x)Ex~∼x,σi2I[∥sθ(x~,σi)+x~−xσi2∥22]=12Epdata(x)Ex~∼x,σi2I[∥σisθ(x~,σi)+x~−xσi∥22]\lambda(\sigma_i) \ell(\theta;\sigma_i) \\= \sigma_i^2 \frac{1}{2} \mathbb{E}_{p_{data}(x)} \mathbb{E}_{\tilde{x} \sim \mathcal{x,\sigma_i^2 \textit{I}}} \left [ \left\lVert s_{\theta}(\tilde{x},\sigma_i) + \frac{\tilde{x}-x}{\sigma_i^2} \right\rVert^2_2 \right ] \\= \frac{1}{2} \mathbb{E}_{p_{data}(x)} \mathbb{E}_{\tilde{x} \sim \mathcal{x,\sigma_i^2 \textit{I}}} \left [ \left\lVert \sigma_i s_{\theta}(\tilde{x},\sigma_i) + \frac{\tilde{x}-x}{\sigma_i} \right\rVert^2_2 \right ] λ(σi)ℓ(θ;σi)=σi221Epdata(x)Ex~∼x,σi2I[∥∥∥∥∥sθ(x~,σi)+σi2x~−x∥∥∥∥∥22]=21Epdata(x)Ex~∼x,σi2I[∥∥∥∥∥σisθ(x~,σi)+σix~−x∥∥∥∥∥22]
此时有 x~−xσi∼N(0,I)\frac{\tilde{x}-x}{\sigma_i} \sim \mathcal{N}(0,\textit{I})σix~−x∼N(0,I),这样一来不同的噪声等级都有相同的数量级(量纲)。
原论文中把这个模型称为噪声条件分数网络(Noise Conditional Score Networks,NSCN)。
基于分数的改进采样算法
通过上一步的加噪分数匹配方法,训练出了一个神经网络模型,这个神经网络模型可以预测不同等级的加噪数据的分数 sθ(x~,σi)s_{\theta}(\tilde{x},\sigma_i)sθ(x~,σi) 接下来就是如何利用这个分数预测模型来近似采样生成原始数据分布 pdata(x)p_{data}(x)pdata(x) 的样本。
基于分数的采样方法其实有多种,作者这里采样的郎之万动力采样法(Langevin dynamic sample),然而前文我们讨论过,郎之万动力采样法存在着不足,对于那些存在低密度区域分割成多个高密度区域的复杂分布,需要较多的采样步骤才能得到相对可靠的采样结果,无法在一个可接受的步骤内得到较好的采样结果,针对这个问题,作者提出了一个改进的郎之万动力采样法,称为退火郎之万动力采样法
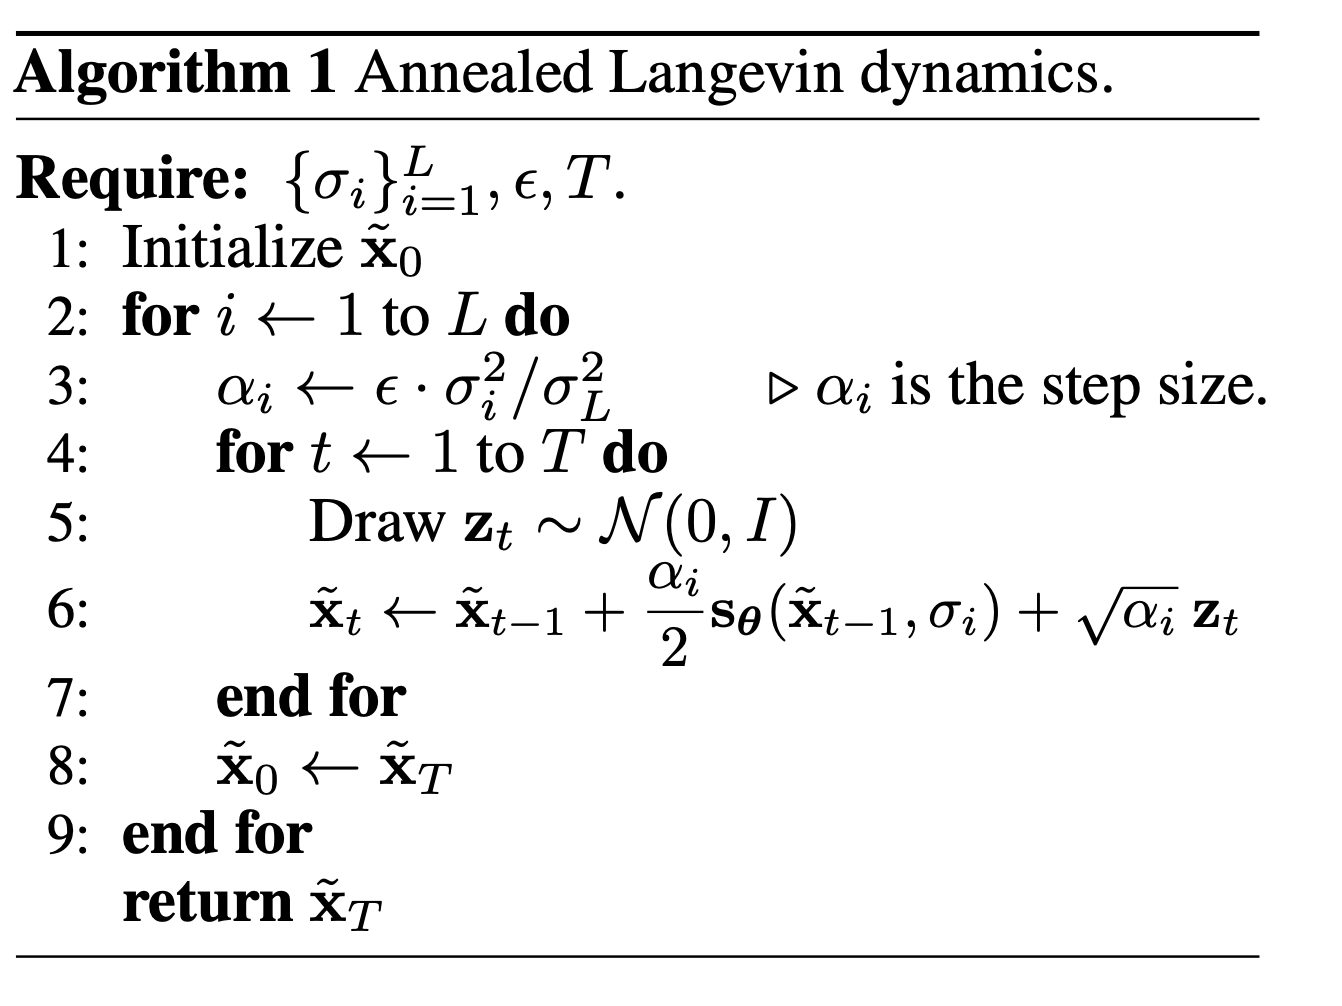
算法的过程其实不复杂,首先初始化超参数 {σi}i=1L\{\sigma_i\}_{i=1}^L{σi}i=1L,然后初始 x~0\tilde{x}_0x~0,它可以是一个均匀分布的随机采样,也可以是高斯分布的随机采样。
接下来就是两层循环,外层循环是噪声等级的循环,从较大噪声等级的 σ1≈=1\sigma_1 \approx=1σ1≈=1,到较小的噪声等级 σL≈0\sigma_L \approx 0σL≈0。内循环是一个郎之万动力采样过程,负责对每个噪声等级下的 qsigmai(x~)q_{sigma_i}(\tilde{x})qsigmai(x~) 进行采样。
这样一直到最后一步 i=Li=Li=L 时,噪声等级足够小了,σL≈0\sigma_L \approx 0σL≈0,此时 qsigmaL(x~)≈pdata(x)q_{sigma_L}(\tilde{x}) \approx p_{data}(x)qsigmaL(x~)≈pdata(x),最后的得到的采样就近似是原数据分布 pdata(x)p_{data}(x)pdata(x) 的采样。
因为是两层循环,内循环是原始的郎之万动力采样,外循环是一个噪声等级逐步降低的过程,两层循环加起来构成了退火郎之万动力采样。
改进的分数生成模型
原始的分数模型,作者在 32×3232 \times 3232×32 的低分辨率图像上做了实验,得到了不错的效果。但是在高分辨率上效果变差了很多。因此作者紧接着又发布了一篇论文,重点在如何改进分数模型,使其在更高分辨率的图像上也能有较好的效果。
作者进行了大量的分析和试验后,提出了了5项改进,这里不再赘述分析和试验过程的细节,只列出这5项改进内容,对细节感兴趣的同学可以阅读原论文 Yang Song and Stefano Ermon. Improved techniques for training score-based generative models. 2020。
- 初始噪声等级 σ1\sigma_1σ1 的最佳设定,它的大小影响图像生成的多样性(这其实很符合直觉认知),σ1\sigma_1σ1 越大多样性越好,σ1\sigma_1σ1 的最佳选择是训练数据集里样本对之间的最大的欧式距离。
- {σi}i=1L\{\sigma_i\}_{i=1}^L{σi}i=1L 设置成公比为 γ\gammaγ 的几何级数,即 γ=σi−1/σi\gamma=\sigma_{i-1}/\sigma_iγ=σi−1/σi,此外 γ\gammaγ 满足约束
Φ(2D(γ−1)+3γ)−Φ(2D(γ−1)−3γ)≈0.5\Phi(\sqrt{2 D}(\gamma-1)+3\gamma)-\Phi(\sqrt{2 D}(\gamma-1)-3\gamma)\approx 0.5Φ(2D(γ−1)+3γ)−Φ(2D(γ−1)−3γ)≈0.5,其中 Φ\PhiΦ 是标准高斯分布的累积分布函数,DDD 是观测变量 xxx 的维数。 - 神经网络模型由原来的的 sθ(x~,σi)s_{\theta}(\tilde{x},\sigma_i)sθ(x~,σi) 改成 sθ(x~)/σis_{\theta}(\tilde{x})/\sigma_isθ(x~)/σi ,把噪声等级 σi\sigma_iσi 从模型输入中去掉, $s_{\theta}(\tilde{x}) $ 称为无条件分数网络(unconditional score network)。
- 在计算预算允许的范围内选择 TTT ,然后选择一个 ϵ\epsilonϵ ,使下列方程最大接近 111,其中 $x_{T} \sim \mathcal{N}(0,s^{2}_T \textit{I}) $。
公式1.17sT2σi2=(1−ϵσL2)2T(γ2−2ϵσL2−σL2(1−ϵσL2)2)+2ϵσL2−σL2(1−ϵσL2)2\frac{s^2_T}{\sigma_i^2} \\= \left( 1-\frac{\epsilon}{\sigma_L^2} \right)^{2T} \left( \gamma^2-\frac{2\epsilon}{\sigma_L^2-\sigma_L^2 \left( 1-\frac{\epsilon}{\sigma_L^2} \right)^2 } \right) + \frac{2\epsilon}{\sigma_L^2-\sigma_L^2 \left( 1-\frac{\epsilon}{\sigma_L^2} \right)^2 } σi2sT2=(1−σL2ϵ)2T⎝⎜⎜⎛γ2−σL2−σL2(1−σL2ϵ)22ϵ⎠⎟⎟⎞+σL2−σL2(1−σL2ϵ)22ϵ - 训练模型时加入指数滑动平均(exponential moving average,EMA)技术,$\theta_{ema} \leftarrow m\theta_{ema} + (1 − m)\theta_t $ ,得到一份 EMA 的模型参数副本,其中 m=0.999m = 0.999m=0.999 是动量参数。在推理时(生成图像)时,用EMA的模型参数 θema\theta_{ema}θema。注意,在应用 EMA 时,实际上是有两套模型参数的,模型训练过程中仍然按照原来的优化器(比如 Adam)去更新参数,只是在每一轮更新结束后,额外更新和保存一份 EMA 版本的参数 θema\theta_{ema}θema。
训练完成后输出保存的是两套模型参数,在推理时可以选择用原始模型参数还是使用 EMA 版本的参数。EMA 版本的参数理论上能缓解原始参数过拟合的情况,
但这也不是总成立的。
经过这五项改进后模型在生成图像的多样性和质量上都得到大幅提升,可以生成较高质量的 256×256256 \times 256256×256 尺寸的图像。
- 文章作者:
- Lthero博客
- 版权声明:
- 本博客所有文章除特别声明外,均采用CC BY-NC-SA 4.0许可协议。转载请注明来自 Lthero博客!


